sesi-1-ann/train.py
Alur utama — dibaca dari atas ke bawah · 62 baris
1"""2Sesi 1 — ANN untuk Deteksi Intrusi Jaringan (NSL-KDD)3Workshop Deep Learning · Teknik Telekomunikasi ITERA4 5Jalankan dari root repo:6 uv run python sesi-1-ann/train.py7 8Pengaturan (epoch, learning rate, dll.) ada di config.py.9Hasil (model, grafik, metrik) disimpan di sesi-1-ann/outputs/.10"""11 12import json13 14import numpy as np15import torch16 17import config18from data import load_nslkdd19from evaluation import evaluate, predict20from model import build_model, count_parameters21from plots import plot_confusion_matrix, plot_loss22from preprocessing import encode_features, make_labels, make_loader, scale_features, split_train_val23from training import train_model24 25# 1. PERSIAPAN — angka acak tetap supaya hasil bisa diulang26np.random.seed(config.SEED)27torch.manual_seed(config.SEED)28 29# 2. MUAT DATA30train_df, test_df = load_nslkdd()31 32# 3. PRA-PEMROSESAN33y_all = make_labels(train_df)34y_test = make_labels(test_df)35X_all, X_test = encode_features(train_df, test_df)36X_train, X_val, y_train, y_val = split_train_val(X_all, y_all)37X_train, X_val, X_test = scale_features(X_train, X_val, X_test)38 39train_loader = make_loader(X_train, y_train, shuffle=True)40val_loader = make_loader(X_val, y_val)41 42# 4. MODEL43model = build_model(n_features=X_train.shape[1])44print(model)45print(f"Total parameter: {count_parameters(model):,}")46 47# 5. TRAINING48history = train_model(model, train_loader, val_loader)49 50# 6. EVALUASI51val_metrics = evaluate("Validasi", y_val, predict(model, X_val))52y_pred = predict(model, X_test)53test_metrics = evaluate("Test (KDDTest+)", y_test, y_pred)54 55# 7. SIMPAN HASIL56config.OUTPUT_DIR.mkdir(exist_ok=True)57torch.save(model.state_dict(), config.OUTPUT_DIR / "model.pt")58plot_loss(history, config.OUTPUT_DIR / "loss_curve.png")59plot_confusion_matrix(y_test, y_pred, config.OUTPUT_DIR / "confusion_matrix.png")60with open(config.OUTPUT_DIR / "metrics.json", "w") as f:61 json.dump({"validation": val_metrics, "test": test_metrics, "history": history}, f, indent=2)62print("\nHasil disimpan di folder sesi-1-ann/outputs/")
sesi-1-ann/config.py
Semua pengaturan eksperimen · 44 baris
1"""2Pengaturan eksperimen.3Ubah angka di sini lalu jalankan ulang train.py untuk mencoba hal baru.4"""5 6from pathlib import Path7 8# ---- Hyperparameter training ----9EPOCHS = 10 # berapa kali model melihat seluruh data latih10BATCH_SIZE = 64 # jumlah data per satu langkah update bobot11LEARNING_RATE = 0.001 # besar langkah gradient descent12VAL_SIZE = 0.2 # 20% data latih disisihkan untuk validasi13PATIENCE = 3 # berhenti jika val loss tidak membaik 3 epoch berturut-turut14SEED = 42 # angka acak tetap -> hasil bisa diulang15 16# ---- Arsitektur model: 122 input -> 64 -> 32 -> 1 output ----17HIDDEN_1 = 6418HIDDEN_2 = 3219 20# ---- Lokasi file (relatif terhadap folder ini) ----21FOLDER = Path(__file__).parent22DATA_DIR = FOLDER / "data"23OUTPUT_DIR = FOLDER / "outputs"24 25# ---- Dataset NSL-KDD (sumber asli: https://www.unb.ca/cic/datasets/nsl.html) ----26TRAIN_URL = "https://raw.githubusercontent.com/defcom17/NSL_KDD/master/KDDTrain%2B.txt"27TEST_URL = "https://raw.githubusercontent.com/defcom17/NSL_KDD/master/KDDTest%2B.txt"28 29# 41 fitur koneksi jaringan + label serangan + tingkat kesulitan30COLUMNS = [31 "duration", "protocol_type", "service", "flag", "src_bytes", "dst_bytes", "land",32 "wrong_fragment", "urgent", "hot", "num_failed_logins", "logged_in", "num_compromised",33 "root_shell", "su_attempted", "num_root", "num_file_creations", "num_shells",34 "num_access_files", "num_outbound_cmds", "is_host_login", "is_guest_login", "count",35 "srv_count", "serror_rate", "srv_serror_rate", "rerror_rate", "srv_rerror_rate",36 "same_srv_rate", "diff_srv_rate", "srv_diff_host_rate", "dst_host_count",37 "dst_host_srv_count", "dst_host_same_srv_rate", "dst_host_diff_srv_rate",38 "dst_host_same_src_port_rate", "dst_host_srv_diff_host_rate", "dst_host_serror_rate",39 "dst_host_srv_serror_rate", "dst_host_rerror_rate", "dst_host_srv_rerror_rate",40 "label", "difficulty",41]42 43# fitur berupa teks (bukan angka) -> perlu one-hot encoding44CATEGORICAL = ["protocol_type", "service", "flag"]
sesi-1-ann/data.py
Unduh & baca NSL-KDD · 29 baris
1"""Mengunduh dan membaca dataset NSL-KDD."""2 3import urllib.request4 5import pandas as pd6 7import config8 9 10def download(url, filename):11 """Unduh file ke folder data/ (hanya jika belum ada)."""12 path = config.DATA_DIR / filename13 if not path.exists():14 print(f"Mengunduh {filename} ...")15 config.DATA_DIR.mkdir(exist_ok=True)16 urllib.request.urlretrieve(url, path)17 return path18 19 20def load_nslkdd():21 """Baca data latih (KDDTrain+) dan data uji (KDDTest+) sebagai tabel."""22 train_path = download(config.TRAIN_URL, "KDDTrain+.txt")23 test_path = download(config.TEST_URL, "KDDTest+.txt")24 25 train_df = pd.read_csv(train_path, names=config.COLUMNS)26 test_df = pd.read_csv(test_path, names=config.COLUMNS)27 28 print(f"KDDTrain+: {len(train_df):,} koneksi | KDDTest+: {len(test_df):,} koneksi")29 return train_df, test_df
sesi-1-ann/preprocessing.py
Label, one-hot, split, scaling, DataLoader · 58 baris
1"""Mengubah tabel mentah menjadi angka yang siap dimasukkan ke model."""2 3import numpy as np4import pandas as pd5import torch6from sklearn.model_selection import train_test_split7from sklearn.preprocessing import StandardScaler8from torch.utils.data import DataLoader, TensorDataset9 10import config11 12 13def make_labels(df):14 """Label biner: normal -> 0, serangan apa pun (DoS, Probe, R2L, U2R) -> 1."""15 is_attack = df["label"] != "normal"16 return is_attack.to_numpy().astype(np.float32)17 18 19def encode_features(train_df, test_df):20 """One-hot encoding untuk 3 fitur teks. Hasil: 41 fitur -> 122 kolom angka."""21 features = train_df.drop(columns=["label", "difficulty"])22 X_train = pd.get_dummies(features, columns=config.CATEGORICAL)23 24 features = test_df.drop(columns=["label", "difficulty"])25 X_test = pd.get_dummies(features, columns=config.CATEGORICAL)26 27 # samakan kolom data uji dengan data latih (kategori yang tidak ada diisi 0)28 X_test = X_test.reindex(columns=X_train.columns, fill_value=0)29 30 print(f"Jumlah fitur setelah one-hot: {X_train.shape[1]}")31 return X_train.to_numpy(np.float32), X_test.to_numpy(np.float32)32 33 34def split_train_val(X, y):35 """Sisihkan sebagian data latih untuk validasi (proporsi normal/serangan dijaga)."""36 X_train, X_val, y_train, y_val = train_test_split(37 X, y, test_size=config.VAL_SIZE, stratify=y, random_state=config.SEED38 )39 print(f"Data latih: {len(X_train):,} | Data validasi: {len(X_val):,}")40 return X_train, X_val, y_train, y_val41 42 43def scale_features(X_train, X_val, X_test):44 """Standardization: rata-rata 0, standar deviasi 1.45 Scaler HANYA belajar dari data latih, lalu dipakai ke validasi & uji."""46 scaler = StandardScaler()47 X_train = scaler.fit_transform(X_train).astype(np.float32)48 X_val = scaler.transform(X_val).astype(np.float32)49 X_test = scaler.transform(X_test).astype(np.float32)50 return X_train, X_val, X_test51 52 53def make_loader(X, y, shuffle=False):54 """Bungkus data menjadi DataLoader yang membagi data ke dalam batch."""55 inputs = torch.tensor(X)56 targets = torch.tensor(y).reshape(-1, 1) # bentuk (N, 1), sama dengan output model57 dataset = TensorDataset(inputs, targets)58 return DataLoader(dataset, batch_size=config.BATCH_SIZE, shuffle=shuffle)
sesi-1-ann/model.py
Arsitektur MLP 122-64-32-1 · 23 baris
1"""Arsitektur ANN (Multi-Layer Perceptron)."""2 3import torch.nn as nn4 5import config6 7 8def build_model(n_features):9 """MLP: input -> hidden 1 (ReLU) -> hidden 2 (ReLU) -> 1 output."""10 model = nn.Sequential(11 nn.Linear(n_features, config.HIDDEN_1),12 nn.ReLU(),13 nn.Linear(config.HIDDEN_1, config.HIDDEN_2),14 nn.ReLU(),15 nn.Linear(config.HIDDEN_2, 1),16 # tanpa sigmoid di sini: sudah termasuk di dalam BCEWithLogitsLoss17 )18 return model19 20 21def count_parameters(model):22 """Jumlah seluruh bobot + bias yang dipelajari model."""23 return sum(p.numel() for p in model.parameters())
sesi-1-ann/training.py
Training loop & early stopping · 71 baris
1"""Proses training: forward, loss, backward, update bobot."""2 3import copy4 5import torch6import torch.nn as nn7 8import config9 10 11def train_one_epoch(model, loader, loss_fn, optimizer):12 """Satu epoch = satu putaran melihat seluruh data latih, batch demi batch."""13 model.train()14 total_loss = 0.015 for inputs, targets in loader:16 outputs = model(inputs) # 1. forward17 loss = loss_fn(outputs, targets) # 2. hitung loss18 optimizer.zero_grad() # 3. hapus gradien lama19 loss.backward() # 4. backpropagation20 optimizer.step() # 5. update bobot21 total_loss += loss.item() * len(inputs)22 return total_loss / len(loader.dataset)23 24 25def validate(model, loader, loss_fn):26 """Hitung loss di data validasi (tanpa mengubah bobot)."""27 model.eval()28 total_loss = 0.029 with torch.no_grad(): # tidak perlu gradien -> lebih cepat30 for inputs, targets in loader:31 outputs = model(inputs)32 total_loss += loss_fn(outputs, targets).item() * len(inputs)33 return total_loss / len(loader.dataset)34 35 36def train_model(model, train_loader, val_loader):37 """Latih model beberapa epoch dan simpan bobot dengan val loss terbaik."""38 loss_fn = nn.BCEWithLogitsLoss() # sigmoid + binary cross-entropy39 optimizer = torch.optim.Adam(model.parameters(), lr=config.LEARNING_RATE)40 41 history = {"train": [], "val": []}42 best_val_loss = float("inf")43 best_weights = None44 epochs_without_improvement = 045 46 print(f"Iterasi per epoch: {len(train_loader)}")47 for epoch in range(1, config.EPOCHS + 1):48 train_loss = train_one_epoch(model, train_loader, loss_fn, optimizer)49 val_loss = validate(model, val_loader, loss_fn)50 history["train"].append(train_loss)51 history["val"].append(val_loss)52 53 mark = ""54 if val_loss < best_val_loss:55 # model membaik -> simpan salinan bobotnya56 best_val_loss = val_loss57 best_weights = copy.deepcopy(model.state_dict())58 epochs_without_improvement = 059 mark = " *"60 else:61 epochs_without_improvement += 162 63 print(f"Epoch {epoch:2d}/{config.EPOCHS} | train loss {train_loss:.4f} | val loss {val_loss:.4f}{mark}")64 65 # early stopping: berhenti jika sudah lama tidak membaik (mencegah overfitting)66 if epochs_without_improvement == config.PATIENCE:67 print(f"Early stopping: val loss tidak membaik selama {config.PATIENCE} epoch")68 break69 70 model.load_state_dict(best_weights) # kembalikan ke bobot terbaik71 return history
sesi-1-ann/evaluation.py
Prediksi & metrik · 33 baris
1"""Mengukur kinerja model: prediksi, metrik, dan confusion matrix."""2 3import torch4from sklearn.metrics import accuracy_score, confusion_matrix, f1_score, precision_score, recall_score5 6 7def predict(model, X):8 """Prediksi 0 (normal) atau 1 (serangan) untuk setiap koneksi."""9 model.eval()10 with torch.no_grad():11 outputs = model(torch.tensor(X))12 probabilities = torch.sigmoid(outputs) # ubah output menjadi peluang 0..113 predictions = (probabilities > 0.5).float() # ambang batas 0.514 return predictions.numpy().flatten()15 16 17def evaluate(name, y_true, y_pred):18 """Cetak metrik evaluasi dan kembalikan dalam bentuk dictionary."""19 metrics = {20 "accuracy": accuracy_score(y_true, y_pred),21 "precision": precision_score(y_true, y_pred),22 "recall": recall_score(y_true, y_pred),23 "f1": f1_score(y_true, y_pred),24 }25 tn, fp, fn, tp = confusion_matrix(y_true, y_pred).ravel()26 27 print(f"\n[{name}]")28 print(f" Akurasi : {metrics['accuracy']:.4f}")29 print(f" Precision: {metrics['precision']:.4f}")30 print(f" Recall : {metrics['recall']:.4f} <- serangan yang terdeteksi")31 print(f" F1 : {metrics['f1']:.4f}")32 print(f" TP={tp:,} FN={fn:,} (serangan lolos) FP={fp:,} (alarm palsu) TN={tn:,}")33 return metrics
sesi-1-ann/plots.py
Grafik loss & confusion matrix · 43 baris
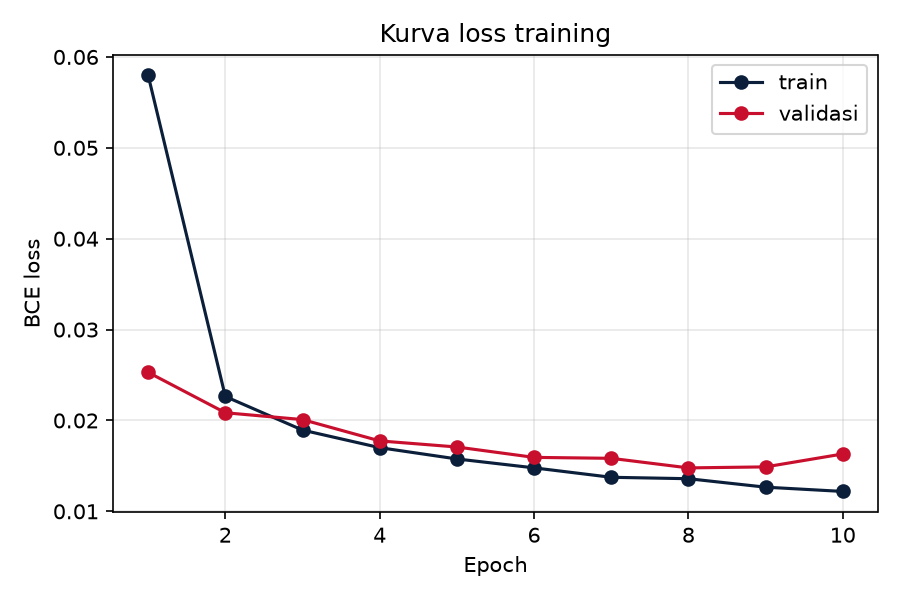
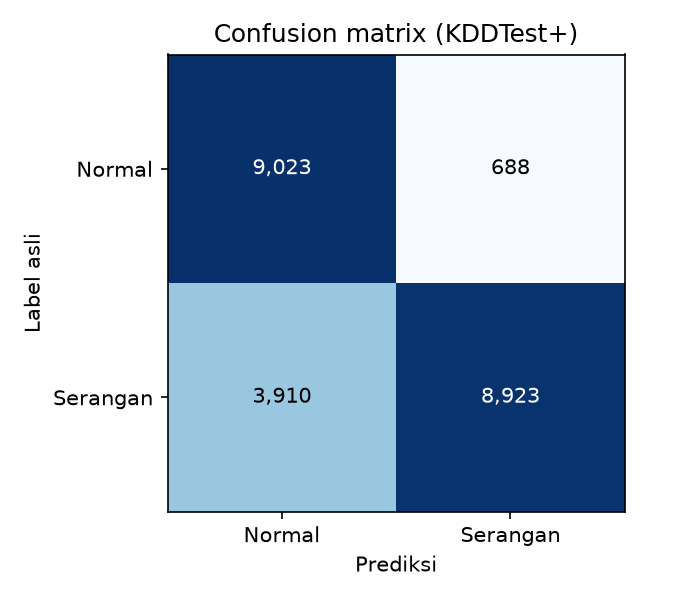
1"""Membuat grafik hasil training."""2 3import matplotlib4 5matplotlib.use("Agg") # simpan grafik ke file, tanpa membuka jendela6import matplotlib.pyplot as plt7from sklearn.metrics import confusion_matrix8 9 10def plot_loss(history, path):11 """Kurva loss train vs validasi per epoch."""12 epochs = range(1, len(history["train"]) + 1)13 plt.figure(figsize=(6, 4))14 plt.plot(epochs, history["train"], "o-", color="#0B1F3A", label="train")15 plt.plot(epochs, history["val"], "o-", color="#C8102E", label="validasi")16 plt.xlabel("Epoch")17 plt.ylabel("BCE loss")18 plt.title("Kurva loss training")19 plt.grid(alpha=0.3)20 plt.legend()21 plt.tight_layout()22 plt.savefig(path, dpi=150)23 plt.close()24 25 26def plot_confusion_matrix(y_true, y_pred, path):27 """Confusion matrix: baris = label asli, kolom = prediksi."""28 cm = confusion_matrix(y_true, y_pred)29 labels = ["Normal", "Serangan"]30 plt.figure(figsize=(4.5, 4))31 plt.imshow(cm, cmap="Blues")32 for i in range(2):33 for j in range(2):34 color = "white" if cm[i, j] > cm.max() / 2 else "black"35 plt.text(j, i, f"{cm[i, j]:,}", ha="center", va="center", color=color)36 plt.xticks([0, 1], labels)37 plt.yticks([0, 1], labels)38 plt.xlabel("Prediksi")39 plt.ylabel("Label asli")40 plt.title("Confusion matrix (KDDTest+)")41 plt.tight_layout()42 plt.savefig(path, dpi=150)43 plt.close()